个人开发者打造的本地大模型运行器,离线可用无广告。
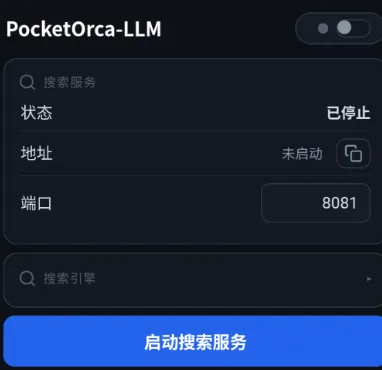
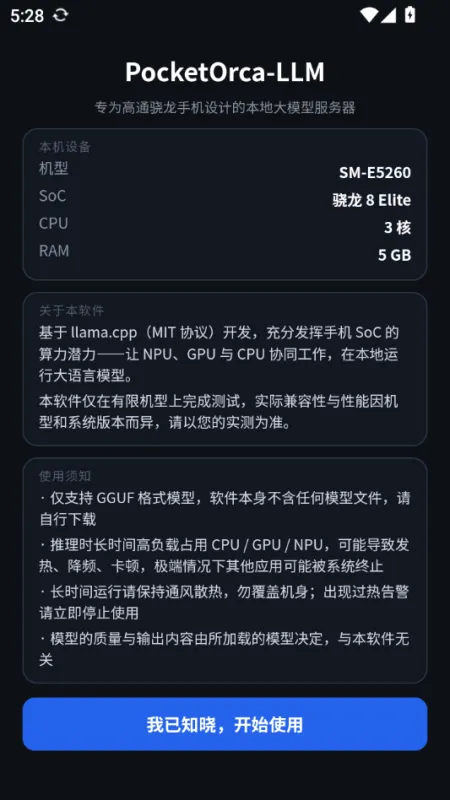
PocketOrca-LLM 是移动端离线大模型运行工具,适配骁龙系列芯片,充分调用手机 NPU 算力加速推理,支持导入 GGUF 格式本地大模型。软件自带对话窗口、命令行调试、搜索服务功能,可自主设置端口启动本地服务,所有对话推理都在本机完成,不用联网。高负载运行会带来发热,适合有一定基础、想要离线体验本地大模型的玩家。
核心定位:让手机成为可用的本地大模型服务器,而非仅能运行但无法实用化的设备。
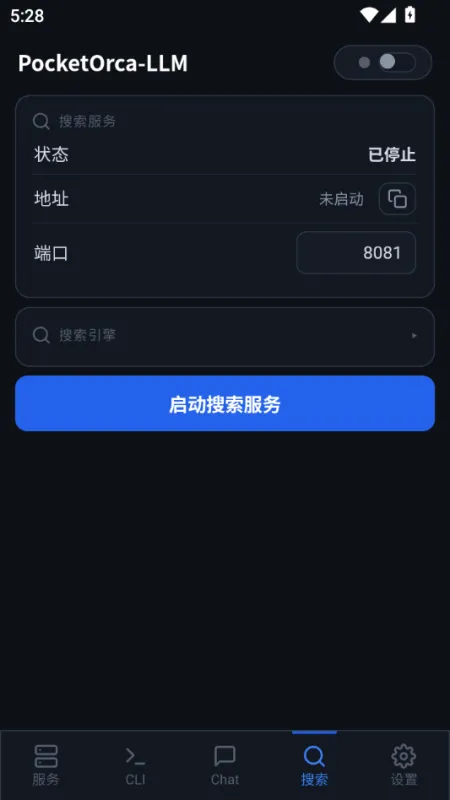
服务方式:对外暴露兼容 OpenAI API 格式的 HTTP 接口,现有基于 OpenAI SDK 的代码只需修改 base_url 为手机局域网地址即可直接使用。
启动流程:加载模型权重、初始化 KV Cache 池、运行算子性能画像、启动 HTTP 服务,整个过程约 20 到 60 秒。
访问地址:服务启动后显示局域网访问地址,格式通常为 http://<手机 IP>:8000/v1。
算子性能画像:内置算子性能画像功能,首次运行时对关键算子做微基准测试,记录不同计算单元在不同形状下的实际耗时。
性能提升:画像过程约需 30 秒到 1 分钟,但可换来后续推理速度提升 20% 到 40%。
优化设计:从模型量化、内存管理、推理调度三个层面重新设计,适配手机有限硬件资源。
性能影响因素:端侧推理体验上限取决于手机 SoC 的内存带宽和散热设计,同样 8GB 内存的不同芯片实际推理速度可能差出一倍以上。
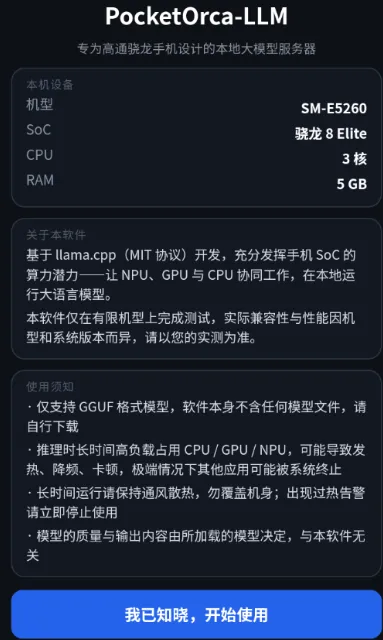
1、专为高通骁龙手机打造的本地大模型服务工具,基于 llama.cpp 开发,支持加载 GGUF 格式本地大模型,在手机端离线运行大语言模型;
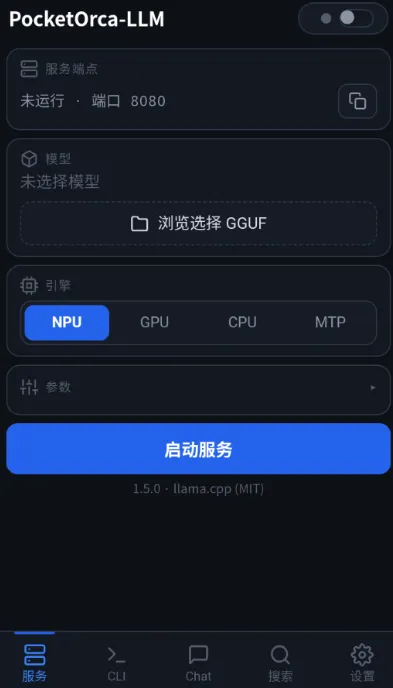
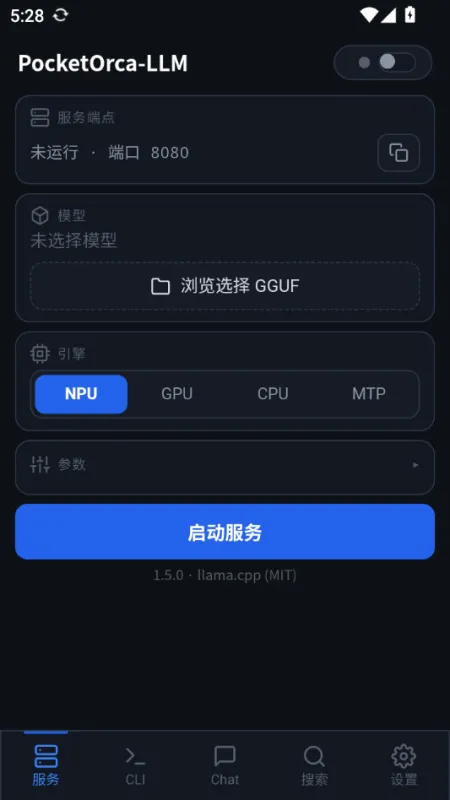
2、支持 NPU、GPU、CPU、MTP 多引擎切换推理,可自定义服务端口,一键启动本地模型服务,提供服务端点;
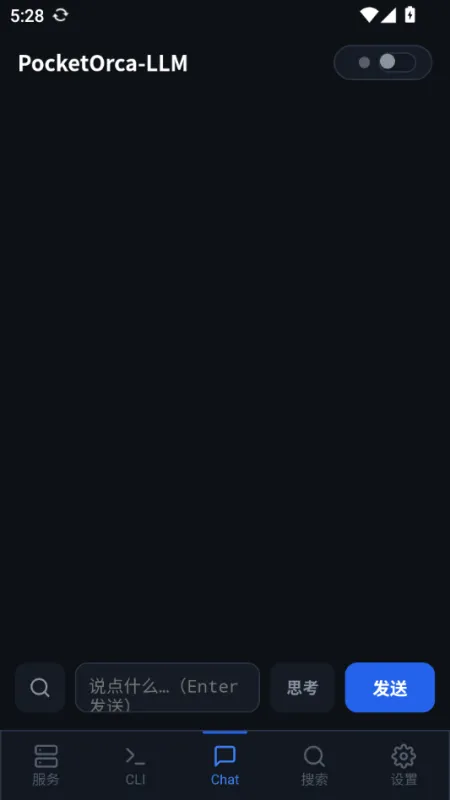
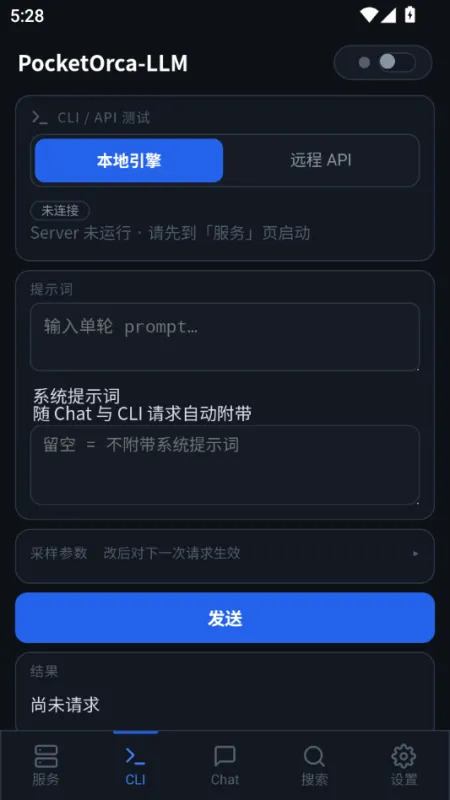
3、内置 Chat 对话窗口、CLI 命令行、搜索服务三大板块,支持本地对话交互、指令调试,可单独启动搜索服务;
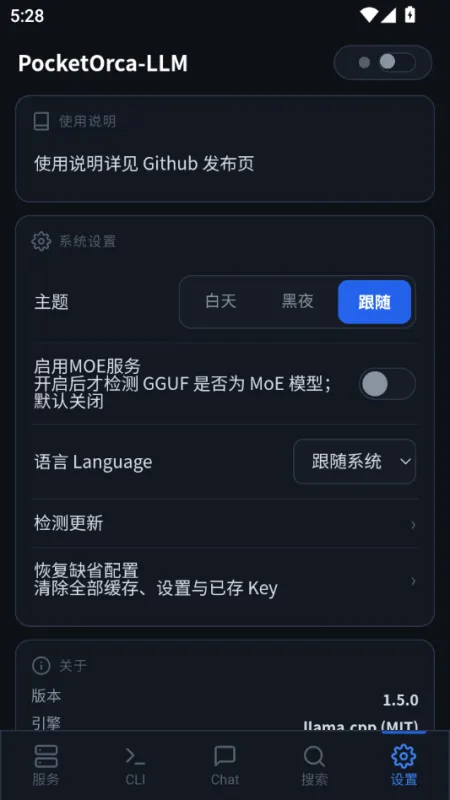
4、自带参数调节面板,可调整模型推理参数,自动识别本机 SoC、内存等硬件信息,查看设备运行状态。
1、针对骁龙芯片深度优化,调用 NPU 加速推理,释放手机本地算力,无需联网即可运行大模型;
2、分区功能清晰,服务、命令行、对话、搜索、设置独立标签,操作逻辑直观;
3、本地私有化推理,对话数据不上传网络,隐私性强;支持自定义端口,可对接其他客户端调用本地服务;
4、开源协议开发,软件本体不含模型,由用户自主导入 GGUF 模型,自由度高。
1、搭载高通骁龙处理器,想要手机离线跑大模型的玩机爱好者;
2、注重对话隐私,不想把对话数据上传云端的用户;
3、AI 本地部署爱好者,需要调试、测试 GGUF 格式大模型的玩家;
4、想要本地搭建 LLM 服务,对接其他工具调用的技术用户。
1、打开软件,阅读须知确认后进入主界面,浏览选择本地 GGUF 格式模型文件;
2、根据手机硬件选择 NPU/GPU/CPU/MTP 推理引擎,按需调整推理参数;
3、设置服务端口,点击启动服务,服务正常运行后,切换 Chat 页面进行本地对话;
4、可单独启动搜索服务,也可进入 CLI 命令行进行模型调试,在设置里调整相关配置。
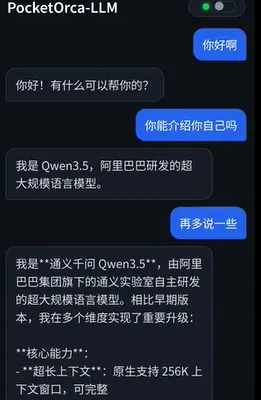
PocketOrca-LLM 是骁龙手机上很不错的本地大模型部署工具,依托 NPU 加速,推理速度相比纯 CPU 快很多,离线运行不用担心隐私泄露。支持标准 GGUF 模型,端口开放方便对接其他程序。缺点是对手机性能有要求,高负载推理容易发热降频,模型需要自行下载,新手上手门槛偏高。
v1.5.0版本
新增内容导出通用文本文件保存本地记录
优化 UI 元素适配全面屏、水滴屏各类机型
修复快捷悬浮球点击无响应拖动界面卡顿
优化云端同步传输速率弱网络同步更稳定
新增操作确认弹窗开关关闭二次确认提示
修复页面索引跳转定位偏差无法直达目标位置
新增本地内容快速检索索引提升查找速度
6.9
500+人评价
请为应用评分:
游龙安全护盾工具
实用工具/87.7MB 2026-11-03更新
小草助手手机版
实用工具/30MB 2026-08-27更新
月虹提权助手
实用工具/13.5MB 2026-10-11更新
游龙工具箱内测版
实用工具/73.9MB 2026-10-24更新
小小电脑
实用工具/946MB 2026-05-16更新
萌娘助手
实用工具/52.9MB 2026-07-27更新
Rotating Art Launcher
实用工具/105.11MB 2026-05-21更新
中兴云电脑(公众版)
实用工具/185.1MB 2026-10-31更新
OrbitV
实用工具/57.4MB 2026-03-26更新
跑满了吗
实用工具/138.86MB 2026-09-08更新
 WorkBuddy



 MG Ai
 热区软件库
 嗨豹云电脑
 lxlovo
 小怪兽
 肉呆去广告
 起源自动注入
 Cross Profile Test
 X Launcher
 登月计划
 麦子
 远离手机